
 ChatGPT
 Perplexity
 Gemini
 Claude
 Grok
Une boîte de notes manuscrites, de carnets de recherche ou de formulaires remplis crée le même problème. Leurs informations restent difficiles à rechercher, à modifier ou à réutiliser jusqu'à ce que quelqu'un tape tout manuellement. Pour les collections plus importantes, cela devient rapidement fastidieux et peu pratique.
L'OCR manuscrit peut supprimer une grande partie de ce travail, en particulier avec une écriture moderne et claire. La précision devient moins prévisible avec l'écriture cursive, les écritures mixtes et les mauvaises numérisations, ce qui rend le choix de l'outil important. Ci-dessous, nous comparons 5 options pour différents documents et expliquons 6 habitudes de numérisation qui peuvent améliorer les résultats de reconnaissance.
 100% sécurité garantie
 Propulsé par l'IA100% sécurité garantie Propulsé par l'IA 100% sécurité garantie Propulsé par l'IA 100% sécurité garantie Propulsé par l'IA
Dans cet article
Partie 1. Ce qu'est l'OCR manuscrit
La reconnaissance optique de caractères convertit le texte d'une image en caractères lisibles par machine, qui peuvent être recherchés, copiés et modifiés. Lorsque la source contient de l'écriture manuscrite plutôt que du texte imprimé, la tâche est plus précisément connue sous le nom de reconnaissance de texte manuscrit (HTR).
OCR manuscrit vs OCR traditionnel
L'OCR imprimé présente généralement un problème de reconnaissance plus facile, car les polices de caractères contiennent des formes de caractères et des espacements relativement cohérents. L'écriture manuscrite introduit une variation bien plus grande. Les formes des lettres peuvent varier d'un scripteur à l'autre, au sein d'un même document, et même à l'intérieur d'un seul mot.
Les systèmes modernes diffèrent également des méthodes de reconnaissance plus anciennes. Plutôt que de simplement faire correspondre des caractères à des polices stockées, les systèmes OCR et HTR contemporains peuvent utiliser des modèles d'apprentissage automatique pour apprendre des modèles visuels et des relations contextuelles. Une enquête de 2025 sur la recherche en reconnaissance de texte manuscrit retrace ce passage des premières approches heuristiques aux modèles neuronaux modernes, tout en identifiant la variabilité de l'écriture manuscrite comme un défi de reconnaissance persistant.
| Aspect | OCR traditionnel | OCR manuscrit |
| Base de correspondance | Une bibliothèque finie de polices connues | Modèles appris à partir de millions d'exemples |
| Séparation des caractères | Les lettres sont espacées et se divisent nettement | La cursive connecte les traits, brouillant les limites |
| Principal obstacle | Qualité de numérisation et polices inhabituelles | Variation entre les scripteurs et au sein d'une même page |
| Comment les erreurs apparaissent | Caractères brouillés et non-sens évidents | Mots plausibles qui semblent corrects à la lecture |
Les différences importent lors de la vérification du résultat. Les systèmes modernes de reconnaissance de l'écriture manuscrite peuvent utiliser les caractères ou mots environnants pour résoudre les incertitudes d'écriture. Le contexte peut améliorer la reconnaissance, mais cela signifie également qu'une prédiction incorrecte peut encore sembler linguistiquement plausible. Pour les documents importants, il convient donc de vérifier l'écriture manuscrite reconnue par rapport à l'image originale plutôt que de supposer qu'elle est exacte.
Partie 2. Comment effectuer l'OCR manuscrit
Le choix du bon outil pour l'OCR à partir de l'écriture manuscrite dépend de votre type de document et de ce que vous envisagez de faire avec le texte extrait. Les 5 options ci-dessous couvrent différents besoins, des notes quotidiennes et des PDF aux documents historiques et aux projets de transcription plus importants :
1. Wondershare PDFelement : Le meilleur pour l'OCR manuscrit basé sur PDF
Les PDF manuscrits numérisés deviennent souvent difficiles à gérer lorsque vous devez modifier le texte. Les outils de reconnaissance de base peuvent extraire des mots mais laisser la gestion des documents pour plus tard. Cela ajoute des étapes supplémentaires lorsque vous avez besoin de corrections, d'annotations ou de modifications de pages. Un flux de travail PDF plus complet peut regrouper ces tâches efficacement.
PDFelement résout ce problème en combinant la reconnaissance avec des outils d'édition PDF. Il convertit l'écriture manuscrite numérisée en contenu PDF consultable et modifiable pour une réutilisation ultérieure. Vous pouvez ensuite corriger le texte, annoter les pages et réorganiser les documents directement. Cela rend PDFelement particulièrement pratique pour l'écriture manuscrite stockée principalement dans des fichiers PDF.
Comment utiliser PDFelement pour l'OCR manuscrit
L'exécution de la reconnaissance elle-même prend 4 étapes, d'une nouvelle numérisation à un fichier consultable :
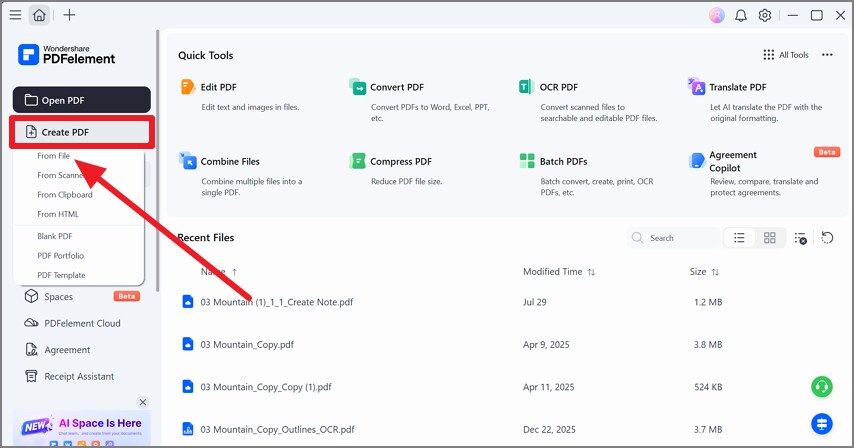
Étape 1. Créer un PDF à partir de votre numérisation
Ouvrez PDFelement et sélectionnez « Créer un PDF » dans la barre latérale gauche. Choisissez « Depuis un fichier, » puis sélectionnez le document numérisé que vous souhaitez traiter.
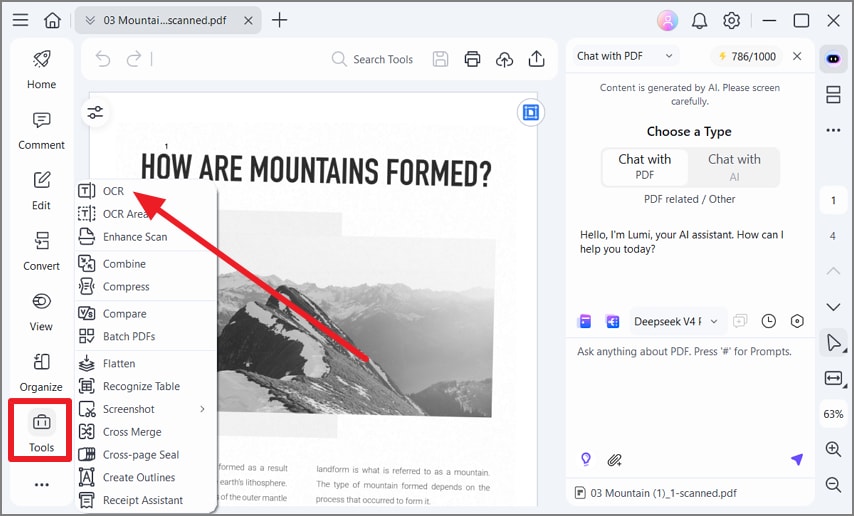
Étape 2. Accéder à l'outil OCR
Une fois le PDF numérisé ouvert, sélectionnez « Outils » dans la barre latérale gauche. Choisissez « OCR » dans le menu des outils pour ouvrir les paramètres de reconnaissance de votre document.
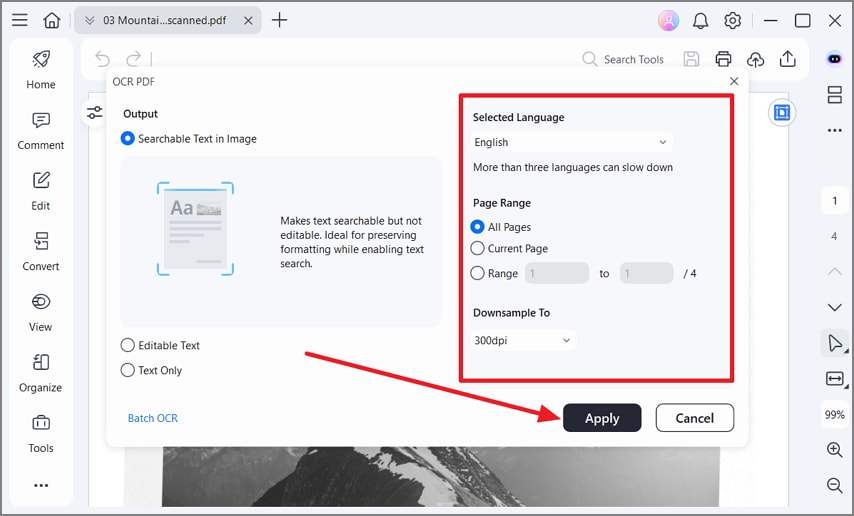
Étape 3. Choisir vos paramètres OCR
Sélectionnez la sortie souhaitée, telle que « Texte consultable dans l'image, » « Texte modifiable, » ou « Texte uniquement ». Choisissez la langue de reconnaissance et la plage de pages, puis cliquez sur « Appliquer » pour commencer le traitement.
 100% sécurité garantie Propulsé par l'IA100% sécurité garantie Propulsé par l'IA 100% sécurité garantie Propulsé par l'IA 100% sécurité garantie Propulsé par l'IA
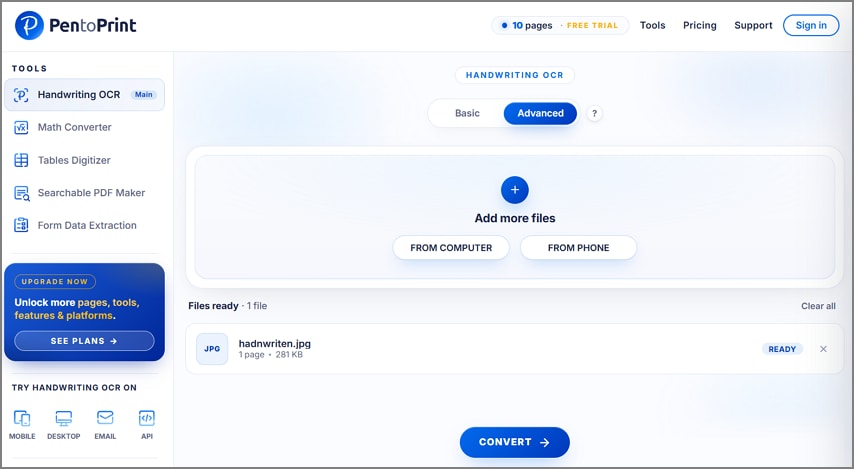
2. PenToPrint : Le meilleur pour la conversion dédiée de l'écriture manuscrite
L'OCR général peut avoir du mal avec l'écriture cursive ou désordonnée, rendant les pages manuscrites difficiles à numériser. PenToPrint se concentre sur l'OCR du texte manuscrit, en convertissant les pages en contenu numérique modifiable. Il prend en charge l'accès web, mobile, bureau et API pour différents flux de travail.
3. Transkribus : Le meilleur pour les documents historiques et d'archives
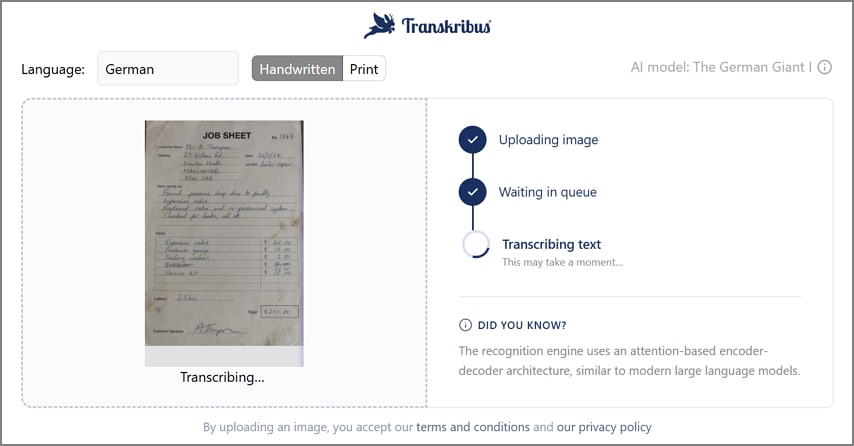
Les archives historiques contiennent souvent une écriture manuscrite que les outils OCR généraux ont du mal à interpréter avec précision. La reconnaissance de l'écriture manuscrite devient plus difficile lorsque les scripts, les styles d'écriture et les mises en page varient considérablement. Transkribus est conçu pour ces flux de travail d'archivage exigeants, avec des modèles entraînés sur des millions de mots manuscrits. Son analyse de mise en page peut identifier les lignes, les colonnes et les notes marginales avant que la reconnaissance ne commence.
4. Lido : Le meilleur pour les données structurées issues de documents manuscrits
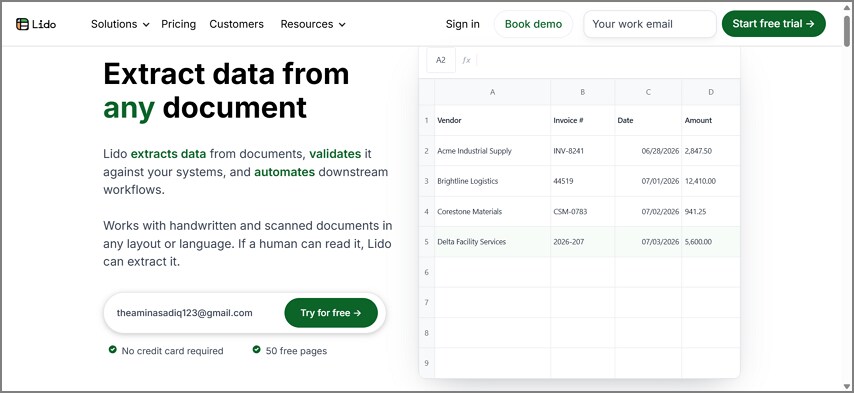
Le texte brut n'est pas toujours utile lorsque des formulaires manuscrits contiennent des champs spécifiques. L'OCR à partir de l'écriture manuscrite peut devenir plus précieux lorsque les informations extraites sont déjà organisées pour l'analyse. Lido lit les documents manuscrits et place les champs identifiés dans des colonnes de feuilles de calcul, réduisant ainsi le tri manuel par la suite. Il gère également les mises en page variables sans nécessiter de modèle au préalable.
5. Adobe Scan : Idéal pour la capture mobile
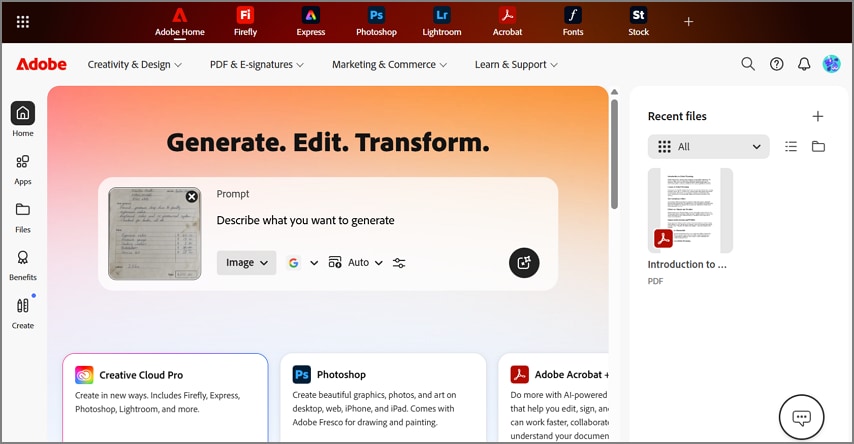
Parfois, la contrainte commence par l'appareil photo plutôt que par le moteur de reconnaissance. La ROC du texte manuscrit fonctionne mieux lorsque l'image source est nette, plate et bien capturée. Adobe Scan transforme un téléphone en un scanner de documents performant, corrigeant automatiquement la perspective et améliorant le contraste. La capture et la conversion se font ensemble, ce qui le rend pratique pour les notes qui n'existent que sur papier.
Partie 3. Comment améliorer la précision de la ROC de l'écriture manuscrite
Aucun outil n'atteint une précision totale sur l'écriture manuscrite, les résultats doivent donc toujours être vérifiés. La qualité de l'image, la lisibilité, la résolution et les conditions du document peuvent affecter les performances de la ROC. Les directives actuelles de l'IBM en matière de ROC identifient ces facteurs comme des influences importantes sur la précision de la reconnaissance.
De meilleures images sources donnent à la ROC du texte manuscrit des informations plus claires à traiter. Les 6 habitudes simples ci-dessous peuvent aider à réduire les erreurs de reconnaissance évitables :
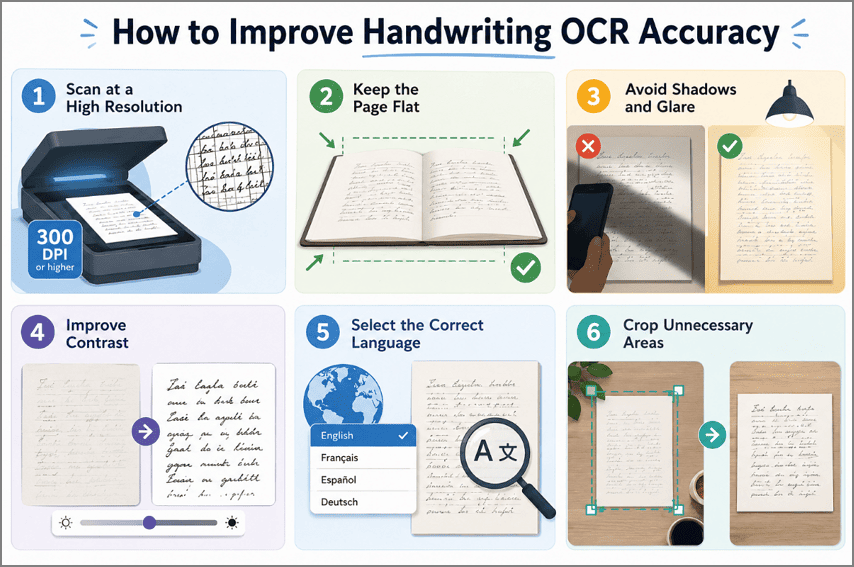
- Numériser à haute résolution : Les détails qui n'ont jamais atteint le fichier ne peuvent pas être récupérés par la suite, et 300 points par pouce constitue un seuil raisonnable.
- Garder la page à plat : Le papier courbé déforme les formes des lettres et perturbe la détection des lignes qui s'effectue avant la reconnaissance.
- Éviter les ombres et les reflets : Un éclairage uniforme est préférable à un éclairage intense, et une main ou un téléphone projetant une ombre sur la page nuit à la précision.
- Améliorer le contraste : Le crayon pâle et l'encre à faible contraste sont plus difficiles à distinguer du papier, il est donc utile d'augmenter le contraste avant le traitement.
- Sélectionner la langue correcte : La reconnaissance utilise le contexte des mots pour résoudre les lettres ambiguës, ce qui ne fonctionne que lorsque le paramètre de langue correspond.
- Recadrer les zones inutiles : La suppression des marges, des bords et des éléments d'arrière-plan superflus permet de concentrer le traitement sur l'écriture elle-même.
Questions fréquemment posées
La ROC de l'écriture manuscrite peut-elle reconnaître l'écriture cursive ?
Les outils modernes gèrent l'écriture cursive bien mieux que les anciens moteurs de ROC, car ils lisent les mots plutôt que les caractères isolés. La précision reste inférieure à celle obtenue avec une impression soignée, notamment lorsque les lettres sont fortement liées.
Quelle est la précision de la ROC de l'écriture manuscrite ?
Une impression soignée et cohérente d'un seul rédacteur produit les meilleurs résultats. L'écriture cursive, les styles mixtes, l'encre décolorée et les documents historiques réduisent tous la précision ; considérez donc le résultat comme un brouillon nécessitant une révision plutôt que comme une transcription définitive.
La ROC de l'écriture manuscrite peut-elle reconnaître une écriture illisible ?
Une écriture difficile est gérable lorsqu'elle reste cohérente en interne, car le modèle s'adapte à un style reconnaissable. Une écriture qui varie au sein d'une même page est considérablement plus difficile à traiter, et les outils spécialisés surpassent la ROC générale dans ce cas.
Conclusion finale
En conclusion, le choix entre ces outils dépend de votre type de document, de votre flux de travail et du résultat souhaité. Les flux de travail PDF conviennent aux documents modifiables, l'extraction structurée aux formulaires, tandis que les outils d'archivage gèrent les scripts historiques. De bonnes numérisations améliorent également les résultats de la ROC de l'écriture manuscrite avec différents outils. Pour les utilisateurs ayant besoin de reconnaissance associée à l'édition et aux flux de travail PDF, PDFelement est un choix pratique.
100% sécurité garantie Propulsé par l'IA100% sécurité garantie Propulsé par l'IA 100% sécurité garantie Propulsé par l'IA 100% sécurité garantie Propulsé par l'IA